

Günümüzde yapay zeka (YZ) teknolojileri, büyük miktarda veriyi işleyerek çeşitli alanlarda öngörüler sunmak ve kararlar almak için kullanılmaktadır. Bu süreçte bir modelin performansını değerlendirebilmek için bir dizi metrik kullanılır. Bu metriklerden biri de duyarlılık ya da İngilizce terimiyle recall (hatırlama oranı) olarak bilinir. Bu makalede, yapay zekada duyarlılığın ne olduğunu, nasıl hesaplandığını ve uygulama alanlarını detaylandıracağız.
Yapay Zekada Duyarlılık (Recall) Nedir?
1. Duyarlılık (Recall) Nedir?
Duyarlılık, özellikle sınıflandırma (classification) algoritmalarında bir modelin doğru bir şekilde pozitif sınıfı tanıyabilme yeteneğini ölçen bir metriktir. Yani, modelin “pozitif” veya “hedef sınıf” olarak tanımladığı sınıfı ne kadar iyi tespit ettiğini gösterir.
Formül olarak duyarlılık, aşağıdaki gibi hesaplanır:
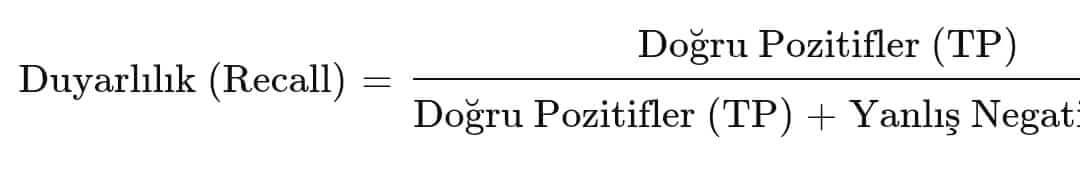
Bu formüldeki her bir terim şöyle açıklanabilir:
- Doğru Pozitifler (TP): Modelin doğru bir şekilde “pozitif” olarak sınıflandırdığı örneklerdir.
- Yanlış Negatifler (FN): Gerçekte “pozitif” olan ancak model tarafından yanlışlıkla “negatif” olarak sınıflandırılan örneklerdir.
Duyarlılık metriği, modelin gözden kaçırdığı (yanlış negatif) pozitif örnekleri azaltmayı amaçlar. Bu nedenle duyarlılık, özellikle yanlış negatiflerin maliyetinin yüksek olduğu durumlarda önemlidir.
2. Duyarlılığın Önemi
Yapay zeka sistemlerinin performansını değerlendirmek için kullanılan birçok metrik vardır. Duyarlılık (recall) özellikle aşağıdaki durumlarda önem kazanır:
- Tıbbi Tanı ve Sağlık Uygulamaları: Örneğin kanser taraması gibi bir sağlık uygulamasında, bir hastanın kanser olduğu halde sağlıklı olarak sınıflandırılması (yanlış negatif) çok büyük bir risk taşır. Bu durumda yüksek bir duyarlılık, yani hastalıklı kişilerin doğru tespit edilmesi büyük önem taşır.
- Spam Filtreleme: E-posta filtreleme sistemlerinde spam olan bir e-postanın gelen kutusunda kalması, kullanıcı için rahatsız edici olabilir. Duyarlılığı yüksek bir model, tüm spam e-postaları doğru bir şekilde tanıyıp filtreleyebilmelidir.
- Sahtecilik Tespiti: Finansal uygulamalarda, dolandırıcılık gibi durumların tespit edilmesi için modelin yüksek duyarlılığa sahip olması gerekir. Yanlış negatiflerin çok olması durumunda, birçok dolandırıcılık vakası gözden kaçabilir.
Bu gibi örneklerde duyarlılık, modelin başarısını belirlemek için kritik bir ölçü olarak öne çıkar.
3. Duyarlılık ile Diğer Metriklerin İlişkisi
Duyarlılık tek başına bir modelin performansını tam olarak ölçmek için yeterli değildir. Duyarlılığı destekleyen diğer metriklerin arasında kesinlik (precision) ve F1 skoru da yer alır.
- Kesinlik (Precision): Modelin pozitif olarak sınıflandırdığı örneklerin gerçekte pozitif olma oranıdır. Kesinlik ile duyarlılık arasındaki denge, modelin başarısı için önemlidir. Özellikle yanlış pozitiflerin (false positives) azaltılması gereken durumlarda kesinlik öne çıkar.
- F1 Skoru: F1 skoru, kesinlik ve duyarlılığı birlikte değerlendiren bir metriktir. Duyarlılığın ve kesinliğin eşit derecede önemli olduğu durumlarda kullanılır. F1 skoru, duyarlılık ile kesinliğin harmonik ortalamasını alır ve bu nedenle dengeleyici bir ölçüm sağlar.
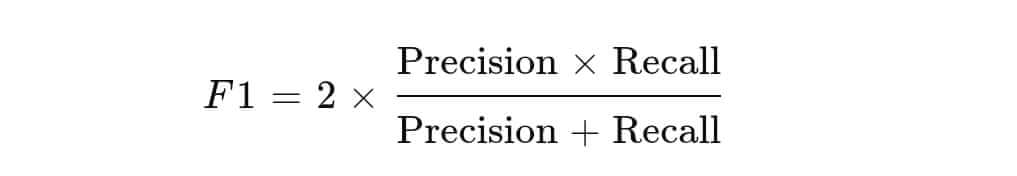
4. Duyarlılığın Hesaplanması: Örnek Uygulama
Bir örnek üzerinden duyarlılığı daha somut hale getirelim. Diyelim ki bir e-posta sınıflandırma modeli geliştiriyoruz ve modelin duyarlılığını ölçmek istiyoruz. Aşağıdaki gibi bir sınıflandırma sonuç tablosu (confusion matrix) olduğunu varsayalım:
| Gerçek Pozitif (Spam) | Gerçek Negatif (Normal) | |
|---|---|---|
| Tahmin Pozitif | 50 | 10 |
| Tahmin Negatif | 5 | 35 |
Bu durumda duyarlılık:
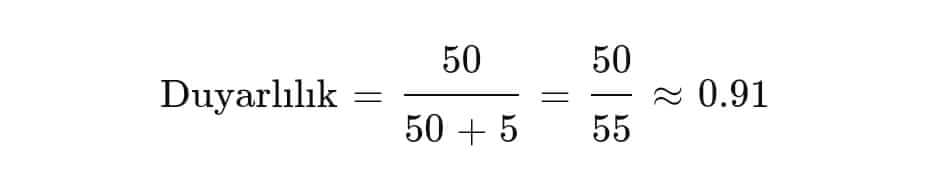
Bu sonuca göre, model %91 oranında spam olan e-postaları doğru şekilde tanıyabilmektedir. Bu değer, modelin pozitif sınıfları tanımada oldukça başarılı olduğunu gösterir.
5. Duyarlılığın Artırılması İçin Stratejiler
Yüksek bir duyarlılık elde etmek için aşağıdaki stratejiler uygulanabilir:
- Veri Ön İşleme: Verinin doğru bir şekilde hazırlanması ve temizlenmesi, duyarlılık üzerinde olumlu etki yapabilir. Veri kalitesinin artırılması, modelin daha doğru sonuçlar vermesine yardımcı olur.
- Model Karmaşıklığını Artırma: Daha karmaşık modeller (örneğin, derin öğrenme algoritmaları) çoğu zaman daha iyi duyarlılık sağlayabilir. Ancak, model karmaşıklığının artırılması hesaplama maliyetlerini de artırabilir.
- Veri Dengeleme Teknikleri: Özellikle dengesiz veri kümelerinde duyarlılık sorunu yaşanabilir. Bu durumda veri dengeleme (resampling) teknikleri ile sınıfların dengelenmesi sağlanabilir.
- Eşik Değerini Ayarlama: Sınıflandırma algoritmalarında duyarlılığı artırmak için karar sınırları değiştirilebilir. Örneğin, pozitif sınıfı belirlemek için kullanılan eşik değerini düşürmek duyarlılığı artırabilir.
Değerlendirme
Yapay zekada duyarlılık (recall), özellikle yanlış negatiflerin maliyetinin yüksek olduğu durumlarda kritik bir metrik olarak öne çıkar. Bir modelin pozitif örnekleri doğru bir şekilde tanıyabilme kapasitesini ölçen bu metrik, tıbbi tanıdan dolandırıcılık tespitine kadar birçok alanda başarıyı belirleyen temel unsurlardan biridir. Ancak, yalnızca duyarlılığa odaklanmak yerine kesinlik ve F1 skoru gibi diğer metriklerle birlikte değerlendirilmesi, modelin genel performansını daha dengeli bir şekilde analiz etmeyi sağlar.




